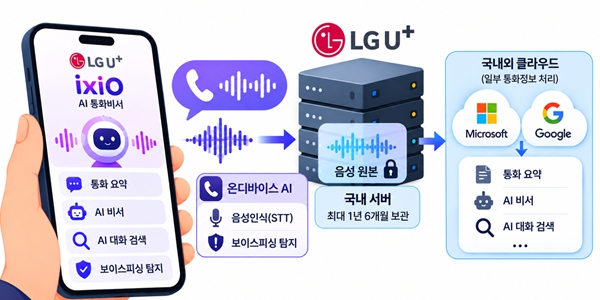
▲ LG유플러스가 AI 통화비서 '익시오' 고도화를 위해 개인 음성통화 원본까지 수집·저장·활용하고 있어, 민감한 통화정보 유출과 오남용을 막기 위한 철저한 보안 대책이 시급하다는 지적이 나오고 있다. <챗GPT 생성 이미지>
익시오에서 이미 서버 설정 오류로 통화 정보가 다른 이용자에게 노출된 사고가 발생한 만큼, 음성통화 원본까지 수집해 AI 학습에 활용하기 위해선 정보 유출 방지책과 오남용을 막을 보호체계를 먼저 구축해야 한다는 것이다.
6일 통신 업계 취재를 종합하면 LG유플러스는 익시오의 음성인식(STT)과 보이스피싱 탐지 등 일부 기능에는 온디바이스 AI를 적용하고, 통화요약과 AI 비서, AI 대화검색 등에는 국내외 클라우드를 활용하는 방식으로 익시오 서비스를 고도화하고 있다.
음성인식(STT)과 보이스피싱 탐지 등은 스마트폰 안에서 처리하지만, 일부 통화정보는 AI 서비스를 제공하기 위해 클라우드에서 처리하는 방식이다.
앞서 비즈니스포스트는 9월18일 '[김재섭의 뒤집어보기] LG유플러스 '익시오' 통화전문의 MS·구글 해외 서버 저장 '논란', 왜 국내에 안 하는지 밝혀야' 기사를 통해 익시오 이용자의 통화 내용 전문(텍스트)이 마이크로소프트(MS)와 구글의 해외 서버에서 처리되는 문제를 제기했다.
이에 LG유플러스는 자체 AI도 익시오에 활용하고 있지만 글로벌 빅테크의 대형언어모델(LLM)이 성능과 효율성 측면에서 우수해 함께 활용하고 있기 때문에 불가피한 측면이 있다고 설명했다.
통화 전문과 통화 요약 등 일부 통화 정보는 해외 클라우드에서 처리될 수 있으나, 음성통화 원본은 해외로 이전하지 않으며 MS와 구글에서 처리되는 이용자 데이터도 이들 기업의 자체 AI 모델 학습에는 사용되지 않도록 계약으로 제한했다고 회사 측은 설명했다.
LG유플러스 관계자는 비즈니스포스트에 “통화음성 파일은 학습용으로 '선택' 동의를 받아 수집하지만, 국내에만 보관하고 외산 AI를 활용하지 않는다”며 “텍스트로 변환된 통화전문은 해외 클라우드의 AI를 활용하기 위해 국외로 이전돼 처리된다”고 말했다.
해외 클라우드 활용에 관한 LG유플러스의 해명과 별개로 익시오 고도화 과정에서 이용자 통화 정보 활용 범위가 갈수록 확대되고 있다.
LG유플러스는 올해 음성통화 원본을 AI 기술 고도화를 위한 연구 데이터로 수집할 수 있도록 정보 활용범위를 넓혔다. 발신자와 수신자가 모두 익시오 이용자이면서 양쪽 모두 별도로 동의한 경우에만 음성통화 원본을 수집한다.
회사가 AI 고도화를 위해 별도 동의를 받아 음성통화 원본을 서버에 수집하는 구조가 추가된 것이다.
LG유플러스는 수집한 음성통화 원본을 모두 AI 학습에 활용하는 것은 아니라고 설명한다.
LG유플러스 관계자는 "하루 수집되는 음성통화 데이터가 수천 시간 규모이지만, 실제 학습에 활용하는 것은 10시간 안팎"이라며 "사람 이름이나 주민등록번호, 계좌번호, 전화번호 등 개인정보가 조금이라도 의심되는 데이터는 제외하고, 안전하다고 판단한 데이터만 학습에 활용하고 있다"고 주장했다.
음성 원본의 국내 보관기간은 최대 1년6개월이며, 학습에 활용하지 않는 것으로 판단한 데이터는 최대 보관기간 이전에 폐기한다고 회사 측은 설명했다.
그럼에도 음성통화 원본에는 이용자의 실제 목소리와 사적인 대화내용이 그대로 담겨 있어, 기존 통화 전문 텍스트나 통화 요약 정보보다 민감도가 더 높다.
AI 고도화를 위해 서버로 수집하는 음성 데이터가 늘어날수록 시스템 설정 오류뿐 아니라 외부 침입이나 내부 오남용 가능성에 대비한 보호조치의 중요성도 커질 수밖에 없다.
익시오가 이미 통화 정보 노출 사고를 겪었다는 점도 이런 우려를 키우는 요인이다.
2025년 12월 익시오 서비스 운영 개선 과정에서 캐시 설정 오류가 발생해 고객 36명의 통화 상대방 전화번호와 통화 시각, 통화 내용 요약 등이 다른 이용자 101명에게 노출됐다.
당시 LG유플러스는 통화 녹음은 이용자 휴대전화에만 보관되지만, 통화 원문을 요약하는 과정에는 LLM 서버를 활용하며, 기기 변경이나 앱 재설치 때도 정보를 복구할 수 있도록 관련 정보를 암호화해 서버에 보관한다고 설명했다.
하지만 서버 설정 오류로 다른 이용자의 통화정보가 노출되면서, 암호화와 이용자 인증 등 정보보호 체계가 제대로 작동했는지를 놓고 의문이 제기됐다.
통화 내용 요약보다 민감도가 더 높은 음성통화 원본까지 회사가 국내 서버에 저장하고 있는 만큼 접근권한 관리와 암호화, 시스템 설정 오류 방지, 불필요한 데이터의 신속한 폐기 등 보호조치를 더 강화해야 한다는 지적이 나오는 이유다.
데이터 처리와 보관방식을 이용자에게 더 투명하게 공개하는 것도 과제다.
9월18일 기사 보도 당시 LG유플러스 측은 비식별 처리된 통화 전문이 MS와 구글의 해외 서버에 올라가 1년6개월 뒤 자동 파기된다고 설명했다.
하지만 이후 통화전문과 음성통화 원본을 국내에 최대 1년6개월 보관하며, 해외 클라우드로 이전된 통화전문은 필요한 처리를 마치면 삭제한다고 다르게 설명했다.
이에 따라 회사가 어떤 통화 정보를 수집·활용하는지뿐 아니라 음성통화 원본을 어떻게 암호화하고 누가 접근할 수 있는지, 접근기록과 삭제 절차를 어떻게 관리하는지 등 구체적 보호체계를 이용자에 투명하게 알리는 게 필요하다는 지적이 나온다.
AI 비서 서비스 고도화 경쟁이 거세질수록 개인 통화 데이터 활용과 민감한 개인정보 보호 사이에서 균형을 찾는 일은 통신업계의 공통 과제로 부상할 것으로 보인다.
SK텔레콤도 에이닷을 중심으로 AI 통화서비스를 고도화하고 있는 만큼 이용자의 통화정보를 AI 서비스에 어느 범위까지 활용하고 보호할 것인지는 개별 통신사를 넘어 업계 전반이 풀어야 할 과제가 될 것으로 보인다. 조승리 기자·김재섭 선임기자